JEP 509: JFR CPU-Time Profiling (Experimental)
Профилирование процессорного времени в JFR, статус Experimental (экспериментальная функция)
| Authors | Jaroslav Bachorík, Johannes Bechberger, & Ron Pressler |
| Ответственный | Johannes Bechberger |
| Тип | Feature |
| Область | JDK |
| Статус | Closed / Delivered |
| Выпуск | 25 |
| Компонент | hotspot / jfr |
| Обсуждение | hotspot dash jfr dash dev at openjdk dot org |
| Трудоёмкость | M |
| Длительность | S |
| Рецензенты | Markus Grönlund |
| Одобрен | Vladimir Kozlov |
| Создан | 2024/08/04 10:34 |
| Обновлён | 2025/07/31 10:19 |
| Задача | 8337789 |
Аннотация
Улучшить JDK Flight Recorder (JFR), чтобы он собирал более точную информацию о профиле процессорного времени в Linux. Это возможность в статусе Experimental.
Мотивация
Работающая программа потребляет вычислительные ресурсы: память, такты процессора и прошедшее время. Профилировать программу — значит измерять, сколько таких ресурсов потребляют отдельные элементы программы. Профиль может показать, например, что один метод потребляет 20 % ресурса, а другой — всего 0,1 %.
Профилирование помогает сделать программу эффективнее, а разработчиков продуктивнее, потому что показывает, какие элементы программы нужно оптимизировать. Без профилирования мы можем оптимизировать метод, который и так потребляет мало ресурсов. Это почти не повлияет на общую производительность программы, а усилия будут потрачены впустую. Например, если метод занимает 0,1 % общего времени выполнения программы и мы ускорим его в десять раз, время выполнения программы сократится всего на 0,09 %.
JFR (JDK Flight Recorder) — средство профилирования и мониторинга в JDK. Основа JFR — механизм с низкими накладными расходами для записи событий, которые генерирует JVM или код программы. Некоторые события, например загрузка класса, записываются всякий раз, когда происходит действие. Другие, например события для профилирования, записываются путём статистической выборки активности программы, пока она потребляет ресурс. Различные события JFR можно включать и выключать. Так при разработке можно собирать более подробную информацию с большими накладными расходами, а в промышленной эксплуатации — менее подробную с меньшими накладными расходами.
Два важных ресурса, которые обычно профилируют, — это память кучи и процессор.
Профиль процессора показывает, какую долю тактов процессора потребляют разные методы. Эта доля не обязательно связана с долей общего времени выполнения, которую занимает метод. Например, метод, сортирующий массив, всё своё время проводит на процессоре. Его время выполнения соответствует числу потреблённых им тактов процессора. А метод, который читает из сетевого сокета, может бо́льшую часть времени бездействовать, ожидая поступления байтов по сети. Из затраченного им времени лишь малая часть приходится на процессор. Тем не менее профиль процессора важен даже для серверных приложений, которые выполняют много операций ввода-вывода: при высокой нагрузке пропускная способность таких приложений может упираться в использование процессора.
JFR хорошо поддерживает профилирование выделения памяти в куче, а поддержка профилирования процессора в нём недостаточна. JFR предлагает приближённое профилирование процессора с помощью механизма, который называется сэмплером выполнения (execution sampler). Когда этот механизм включён, JFR через равные промежутки времени (скажем, каждые 20 мс) получает трассировку стека (выборку) Java-потоков и генерирует её в событии JFR. Подходящий инструмент, в том числе встроенные в JFR представления, может свести эти события в текстовый или графический профиль. Выборка делается только для потоков, которые выполняются, а не ждут какого-либо события, поскольку заблокированные потоки не потребляют процессор.
Этот механизм работает на всех ОС, но у него есть ряд недостатков:
- Он делает выборку только для потоков, которые в данный момент выполняют Java-код, но не нативный код, вызванный из Java-кода.
- Попытка получить выборку может не удаться по техническим причинам, и он не сообщает, сколько таких выборок пропущено.
- На каждом интервале он выбирает для выборки только часть потоков.
Поэтому полученный профиль может быть неточным и не отражать реальный профиль использования процессора. Неточности, скорее всего, будут больше, если собирать выборки за относительно короткий период (скажем, за одну минуту).
Профилирование процессорного времени
Возможность точно и детально измерять потребление тактов процессора появилась в ядре Linux в версии 2.6.12. Её даёт таймер, который генерирует сигналы через фиксированные интервалы процессорного времени, а не через фиксированные интервалы реального прошедшего времени. Большинство профилировщиков в Linux используют этот механизм для построения профилей процессорного времени.
Некоторые популярные сторонние инструменты для Java, в том числе async-profiler, используют процессорный таймер Linux для построения профилей процессорного времени Java-программ. Но для этого такие инструменты взаимодействуют со средой выполнения Java через неподдерживаемые внутренние интерфейсы. Это по своей сути небезопасно и может приводить к аварийному завершению процесса.
Нам следует улучшить JFR, чтобы он использовал процессорный таймер ядра Linux и безопасно строил более точные профили процессорного времени Java-программ. В частности, этот механизм ядра позволил бы JFR правильно учитывать такты процессора, потребляемые Java-программами, даже когда они выполняют нативный код.
Более качественные профили процессора помогли бы многим разработчикам, которые развёртывают Java-приложения в Linux, сделать эти приложения эффективнее.
Описание
Мы добавляем в JFR профилирование процессорного времени, только в системах Linux. Пока эта возможность имеет статус Experimental, чтобы мы могли доработать её с учётом опыта, прежде чем сделать постоянной. В будущем мы можем добавить профилирование процессорного времени в JFR и на других платформах.
JFR будет использовать механизм процессорного таймера Linux, чтобы через фиксированные интервалы процессорного времени делать выборку стека каждого потока, выполняющего Java-код. Каждая такая выборка записывается в событие нового типа — jdk.CPUTimeSample. По умолчанию это событие не включено.
Это событие похоже на существующее событие jdk.ExecutionSample для выборки по времени выполнения. Включение событий процессорного времени никак не влияет на события времени выполнения, поэтому их можно собирать одновременно.
Новое событие можно включить в записи, начатой при запуске, так:
$ java -XX:StartFlightRecording=jdk.CPUTimeSample#enabled=true,filename=profile.jfr ...Пример
Рассмотрим программу HttpRequests с двумя потоками, каждый из которых выполняет HTTP-запросы. Один поток выполняет метод tenFastRequests, который последовательно отправляет десять запросов к конечной точке HTTP, отвечающей за 10 мс; другой выполняет метод oneSlowRequest, который отправляет один запрос к конечной точке, отвечающей за 100 мс. Средняя задержка обоих методов должна быть примерно одинаковой, а значит, и общее время их выполнения должно быть примерно одинаковым.
Однако мы ожидаем, что tenFastRequests займёт гораздо больше процессорного времени, чем oneSlowRequest, так как десять циклов создания запросов и обработки ответов требуют больше тактов процессора, чем один цикл. Если под высокой нагрузкой наша программа упрётся в процессор, оптимизировать следует именно tenFastRequest, и профиль должен это отражать.
Если построить графический профиль программы в виде flame graph с помощью инструмента JDK Mission Control (JMC) по записи новых выборок процессорного времени, действительно становится ясно, что почти все такты процессора приложение тратит в tenFastRequests:
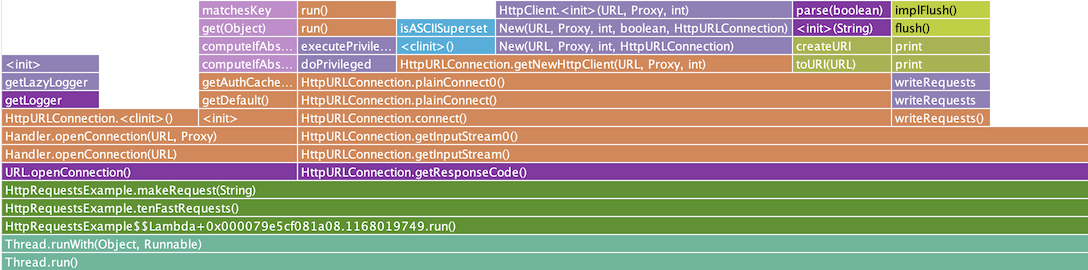
Мы видим эту чёткую разницу между двумя методами (oneSlowRequest потребляет настолько мало процессорного времени по сравнению с tenFastRequests, что не появляется в профиле выше), хотя бо́льшая часть обработки выполняется в нативном коде. Обратите внимание, что нативные функции не отображаются напрямую, но потребляемое ими процессорное время правильно относится на Java-методы, которые их вызывают, — например, на implFlush.
Текстовый профиль горячих по процессору методов, то есть тех, которые потребляют много тактов процессора в собственном теле, а не в вызовах других методов, можно получить так:
$ jfr view cpu-time-hot-methods profile.jfrОднако в этом конкретном примере такой вывод не так полезен, как flame graph.
Подробности события
Событие jdk.CPUTimeSample для конкретной трассировки стека содержит такие поля:
startTime— процессорное время непосредственно перед обходом стека,eventThread— идентификатор потока, для которого сделана выборка,stacktrace— трассировка стека илиnull, если сэмплеру не удалось обойти стек,samplingPeriod— период выборки на момент получения выборки иbiased— может ли выборка быть подвержена safepoint bias.
Частоту выборки для этого события можно задать через свойство события throttle двумя способами:
-
Как период времени: при
throttle=10msсобытие выборки генерируется для каждого платформенного потока после того, как он потребит 10 мс процессорного времени. -
Как общую частоту: при
throttle=500/sкаждую секунду генерируется 500 событий выборки, равномерно распределённых по всем платформенным потокам.
Значение throttle по умолчанию — 500/s, а в конфигурации профилирования, входящей в JDK, profile.jfc, — 10ms. Более высокая частота даёт более точный и детальный профиль ценой увеличения накладных расходов программы на выборку.
Ещё одно новое событие, jdk.CPUTimeSamplesLost, генерируется, когда выборки теряются из-за ограничений реализации, например из-за переполнения внутренних структур данных. Его поле lostSamples содержит число выборок, отброшенных в последнем раунде выборки. Это событие гарантирует, что поток событий в целом правильно отражает общую активность программы на процессоре. Оно включено по умолчанию, но генерируется только тогда, когда включено jdk.CPUTimeSample.
Поскольку эта возможность имеет статус Experimental, эти события JFR помечены соответствующей аннотацией @Experimental на их типе события JFR. В отличие от других видов Experimental-возможностей HotSpot JVM, эти события не нужно специально включать параметрами командной строки, такими как -XX:+UnlockExperimentalVMOptions.
Профилирование в промышленной эксплуатации
Непрерывное профилирование, при котором приложение в промышленной эксплуатации профилируется на протяжении всего времени работы, набирает популярность. Если выбрать значение throttle с достаточно низкими накладными расходами, непрерывный сбор информации о профиле процессорного времени в промышленной эксплуатации может стать практически осуществимым.
Если непрерывное профилирование процессорного времени в промышленной эксплуатации невозможно, другой вариант — время от времени собирать профиль процессора. Сначала создайте подходящий файл конфигурации JFR:
$ jfr configure --input profile.jfc --output /tmp/cpu_profile.jfc \
  jdk.CPUTimeSample#enabled=true jdk.CPUTimeSample#throttle=20ms
Затем с помощью инструмента jcmd начните запись для работающей программы с этой конфигурацией:
$ jcmd <pid> JFR.start settings=/tmp/cpu_profile.jfc duration=4mЗдесь запись останавливается через четыре минуты, но можно выбрать другую длительность или же вручную остановить запись через некоторое время с помощью jcmd <pid> JFR.stop.
Как и любые события JFR, события jdk.CPUTimeSample можно передавать потоком по мере записи, даже по сети удалённому потребителю, для анализа в реальном времени.
Альтернативы
Мы могли бы позволить внешним инструментам использовать сэмплер процессорного времени Linux, добавив для этого безопасные и поддерживаемые нативные API HotSpot. Однако при этом были бы раскрыты внутренние детали среды выполнения, что усложнило бы развитие JDK. Кроме того, такой подход был бы менее эффективным, а значит, менее подходящим для профилирования в промышленной эксплуатации, чем реализация этой возможности непосредственно в JDK.
Зависимости
Реализация этой возможности использует механизм кооперативной выборки, появившийся в JEP 518.