JEP 475: Late Barrier Expansion for G1
Позднее развёртывание барьеров для G1
| Автор | Roberto Castañeda Lozano & Erik Österlund |
| Ответственный | Roberto Castaneda Lozano |
| Тип | Feature |
| Область | Implementation |
| Статус | Closed / Delivered |
| Выпуск | 24 |
| Компонент | hotspot / compiler |
| Обсуждение | hotspot dash gc dash dev at openjdk dot org |
| Трудоёмкость | M |
| Длительность | M |
| Рецензенты | Thomas Schatzl, Vladimir Kozlov |
| Одобрен | Vladimir Kozlov |
| Создан | 2023/12/18 14:09 |
| Обновлён | 2025/01/28 08:42 |
| Задача | 8322295 |
Аннотация
Упростить реализацию барьеров сборщика мусора G1, которые записывают сведения об обращениях приложения к памяти, перенеся их развёртывание с ранних этапов конвейера компиляции JIT-компилятора C2 на более поздние.
Цели
-
Сократить время работы C2 при использовании сборщика G1.
-
Сделать барьеры G1 понятными разработчикам HotSpot, которые не разбираются глубоко в C2.
-
Гарантировать, что C2 сохраняет инварианты относительного порядка обращений к памяти, safepoint-точек и барьеров.
-
Сохранить качество кода, генерируемого C2, как по скорости, так и по размеру.
Что не является целью
- Цель не состоит в том, чтобы сохранить нынешнее раннее развёртывание барьеров G1 как устаревший режим. Переход на позднее развёртывание барьеров должен быть полностью прозрачным, если не считать снижения накладных расходов C2, поэтому такой режим не нужен.
Мотивация
Растущая популярность развёртывания Java-приложений в облаке заставляет уделять больше внимания снижению общих накладных расходов JVM. JIT-компиляция — эффективный способ ускорить Java-приложения, но она влечёт значительные накладные расходы по времени обработки и потреблению памяти. Особенно заметны эти расходы у оптимизирующих JIT-компиляторов, таких как компилятор C2 в JDK. Предварительные эксперименты показывают, что раннее развёртывание барьеров G1, как это делается сейчас, увеличивает накладные расходы C2 примерно на 10–20 % в зависимости от приложения. Это неудивительно, ведь барьер G1 представлен более чем 100 операциями в промежуточном представлении (IR) C2 и даёт около 50 инструкций x64. Снижение этих расходов — ключ к тому, чтобы платформа Java лучше подходила для облака.
Ещё один крупный источник накладных расходов JVM — сборщик мусора. Как полуконкурентный сборщик мусора (GC) с поколениями, G1 взаимодействует с JIT-компиляторами, чтобы оснащать обращения приложения к памяти барьерным кодом. В случае C2 поддержка и развитие этого интерфейса требуют глубокого знания внутреннего устройства C2, которым обладают немногие разработчики GC. Кроме того, некоторые оптимизации барьеров требуют низкоуровневых преобразований и приёмов, которые невозможно выразить в промежуточном представлении C2. Эти препятствия замедлили или прямо заблокировали развитие и оптимизацию ключевых аспектов G1. Отделение барьерной инструментации G1 от внутреннего устройства C2 позволило бы разработчикам GC и дальше оптимизировать G1 и снижать его накладные расходы — как за счёт алгоритмических улучшений, так и с помощью низкоуровневых микрооптимизаций.
C2 компилирует Java-методы в машинный код, используя IR типа sea of nodes («море узлов»). Это IR — разновидность графа зависимостей программы, дающая компилятору большую свободу в планировании машинных инструкций. Хотя это упрощает многие оптимизации и расширяет их область применения, это затрудняет сохранение инвариантов относительного порядка инструкций. В случае барьеров G1 это привело к сложным ошибкам, таким как 8242115 и 8295066. Мы не можем гарантировать отсутствие других проблем подобного рода.
Ранние эксперименты и ручной анализ кода, сгенерированного C2, показывают, что последовательности инструкций, которые C2 генерирует для реализации барьеров, похожи на написанный вручную ассемблерный код, которым интерпретатор байт-кода оснащает обращения к памяти. Это говорит о том, что возможности C2 оптимизировать барьерный код ограничены и что код сопоставимого качества можно было бы получить, если скрыть детали реализации барьеров от C2 и развёртывать их только в конце конвейера компиляции.
Описание
Раннее развёртывание барьеров
Сейчас при компиляции метода C2 смешивает барьерные операции с исходными операциями метода в своём IR типа sea of nodes. C2 развёртывает барьерные операции для каждого обращения к памяти в начале конвейера компиляции, когда разбирает байт-код в операции IR. Этим развёртыванием управляет специальная логика для G1 и C2 через Heap Access API (JEP 304). После развёртывания барьеров C2 единообразно преобразует и оптимизирует все операции на протяжении всего конвейера. Это показано на следующей схеме, где IR<C,P> обозначает IR, специфичное для сборщика C и целевой платформы P (операционная система/архитектура процессора):

Развёртывание барьеров GC на ранних этапах конвейера компиляции даёт два потенциальных преимущества:
-
одну и ту же реализацию барьеров GC, выраженную операциями IR, можно повторно использовать на всех платформах, и
-
C2 может оптимизировать и преобразовывать барьерные операции в пределах всего метода, потенциально улучшая качество кода.
Однако практическая польза от этого ограничена по двум причинам:
-
платформенно-зависимые реализации барьеров G1 всё равно нужны для других режимов выполнения, например для интерпретации байт-кода, и
-
барьерные операции G1 плохо поддаются оптимизации из-за плотности потока управления, ограничений на порядок операций с памятью и других факторов.
У модели раннего развёртывания три ощутимых и существенных недостатка, уже упомянутых выше: она создаёт значительные накладные расходы при компиляции в C2, она непрозрачна для разработчиков GC и из-за неё трудно гарантировать отсутствие проблем с порядком барьеров.
Позднее развёртывание барьеров
Поэтому мы предлагаем развёртывать барьеры G1 как можно позже в конвейере компиляции C2, перенеся этот шаг с разбора байт-кода до самой генерации кода, когда операции IR транслируются в машинный код. Это показано на следующей схеме в тех же обозначениях, что и выше:
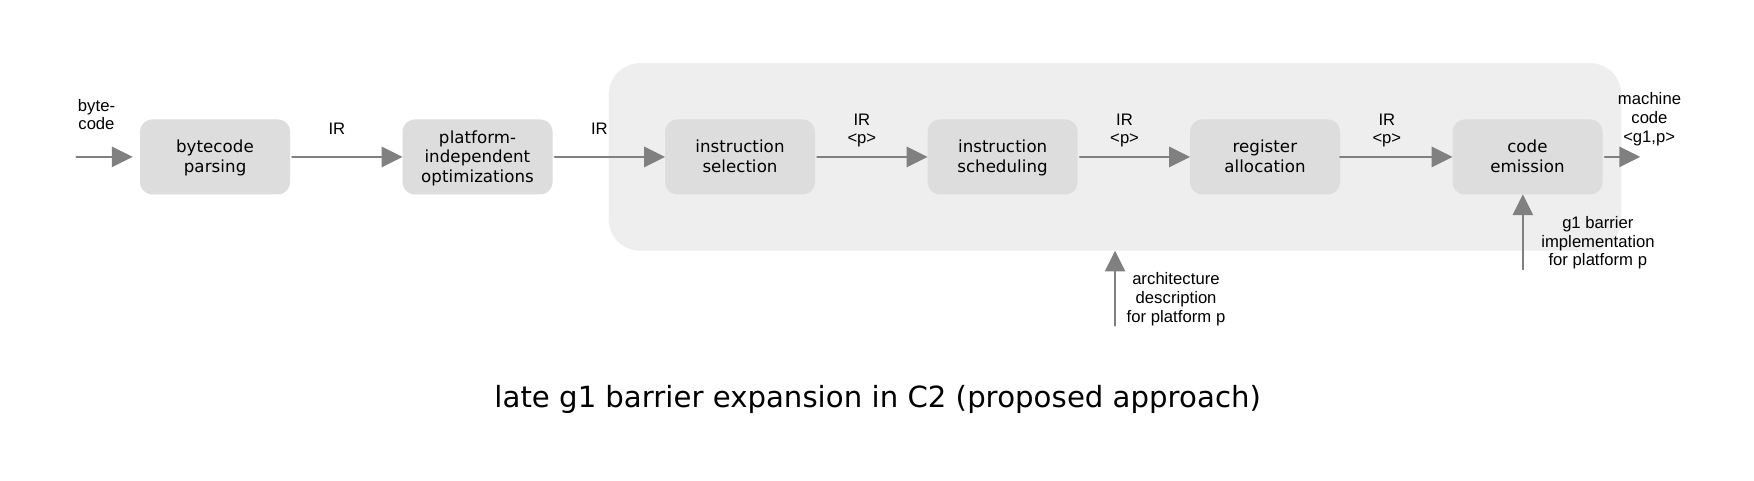
Подробнее, позднее развёртывание барьеров реализовано так:
-
Обращения к памяти в IR, создаваемые при разборе байт-кода, помечаются информацией, необходимой для генерации кода их барьеров на этапе генерации кода. Эта информация не видна механизмам анализа и оптимизации C2.
-
Выбор инструкций заменяет абстрактные операции обращения к памяти инструкциями, специфичными для платформы и GC, но барьеры по-прежнему остаются неявными. На этом этапе вставляются GC-специфичные инструкции, например чтобы распределитель регистров зарезервировал достаточно временных регистров для барьерных операций.
-
Наконец, при генерации кода каждая GC-специфичная инструкция обращения к памяти преобразуется в машинный код в соответствии с прикреплённой к ней информацией о барьерах. Этот код состоит из платформенно-зависимой инструкции обращения к памяти, окружённой барьерным кодом. Барьерный код генерируется с помощью реализации барьеров для интерпретатора байт-кода, дополненной ассемблерными заглушками, которые реализуют вызовы из барьера в JVM.
ZGC, альтернативный полностью конкурентный сборщик в JDK, успешно использует такую схему начиная с JDK 14. Более того, мы считали позднее развёртывание барьеров необходимым условием для достижения стабильности, при которой ZGC можно было признать готовым к промышленному использованию в JDK 15 (JEP 377).
Для позднего развёртывания барьеров в G1 мы повторно используем многие механизмы, разработанные для ZGC, например расширения Heap Access API и логику выполнения вызовов JVM в барьерном коде. Мы также повторно используем реализации барьеров на уровне ассемблера, которые уже существуют для всех платформ для поддержки интерпретации байт-кода. Эти реализации написаны на (псевдо)ассемблере — уровне абстракции, знакомом всем разработчикам HotSpot.
Возможные оптимизации
Предварительные эксперименты показывают, что наивная реализация позднего развёртывания барьеров, без каких-либо оптимизаций, уже даёт качество, близкое к коду, оптимизированному C2. Однако чтобы полностью устранить разрыв в производительности, нужно перенять некоторые ключевые оптимизации, которые сейчас применяет C2. В рамках этой работы или, возможно, в последующей работе мы заново оценим эти оптимизации в контексте позднего развёртывания барьеров и повторно реализуем те из них, которые дают доказуемый выигрыш в производительности на уровне приложения.
Рассматриваемые нами оптимизации касаются барьеров для операций записи, то есть операций вида x.f = y, где x и y — объекты, а f — поле. Предварительные эксперименты показывают, что на них приходится около 99 % всех выполняемых барьеров G1. Барьеры записи состоят из пред-барьера, поддерживающего конкурентную маркировку, и пост-барьера, поддерживающего разделение регионов кучи на поколения.
-
Удаление барьеров для записи в новые объекты — записи в только что выделенные объекты не требуют барьеров, если между выделением и записями нет safepoint-точки. Сейчас C2 заранее удаляет барьеры записи, когда обнаруживает такой шаблон. Мы можем реализовать ту же оптимизацию для позднего развёртывания барьеров, отметив эту ситуацию в информации, прикреплённой к операции записи, а затем опустив соответствующий барьерный код при генерации кода.
-
Упрощение барьеров на основе информации о null — C2 часто может гарантировать, что указатель на объект, сохраняемый при записи в память (
y), либо равен null, либо не равен null. Это может тривиально следовать из исходного байт-кода или выводиться анализом типов C2. Генерация кода может использовать эту информацию, чтобы упростить или даже удалить пост-барьеры, а также упростить сжатие и распаковку указателей на объекты, когда этот режим включён.Сейчас C2 выполняет такие упрощения незаметно с помощью своих универсальных платформенно-независимых механизмов анализа и оптимизации. Мы можем реализовать те же упрощения для позднего развёртывания барьеров, явно пропуская генерацию ненужных барьерных инструкций и инструкций сжатия и распаковки указателей на объекты в соответствии с информацией, которую предоставляет система типов C2. Предварительные эксперименты показывают, что этим приёмом можно упростить или удалить около 60 % выполняемых пост-барьеров записи.
-
Удаление избыточных операций распаковки — когда включено сжатие и распаковка указателей на объекты, запись в память сохраняет сжатый указатель, а барьеры работают с несжатыми указателями. Сейчас глобальный анализ и оптимизация записи и её барьеров в C2 обычно дают одну операцию сжатия, после которой доступны обе версии указателя на объект. Наивная реализация позднего развёртывания барьеров создаёт для каждой записи и операцию сжатия, и операцию распаковки. Мы можем удалить избыточную операцию распаковки, вставляя псевдоинструкции «сжать и записать», соответствующие парам операций IR сжатия и записи. В пределах этих псевдоинструкций мы делаем доступными и сжатую, и несжатую версии указателя на объект с помощью одной операции сжатия, добиваясь того же эффекта, что и нынешняя оптимизация C2.
-
Оптимизация размещения барьерного кода — и пред-барьер, и пост-барьер проверяют, действительно ли барьер нужен; если нужен, барьер вызывает JVM, чтобы сообщить сборщику об операции записи. Предварительные эксперименты, более ранние исследования и исходная статья о G1 показывают, что на практике барьеры нужны нечасто, поэтому большая часть барьерного кода выполняется редко. Сейчас C2 естественным образом размещает редко нужный барьерный код вне основного пути выполнения, повышая эффективность использования кэша кода. Мы можем добиться того же эффекта при позднем развёртывании барьеров, вручную разделив реализацию барьера на часто и редко выполняемые части и развёртывая последние в ассемблерных заглушках.
Альтернативы
Барьеры GC можно развёртывать в нескольких разных точках конвейера компиляции C2:
-
При разборе байт-кода (раннее развёртывание барьеров): барьеры GC развёртываются при первоначальном построении IR.
-
После платформенно-независимых оптимизаций: барьеры GC развёртываются после преобразований циклов, escape-анализа и т. д.
-
После планирования инструкций: барьеры GC развёртываются после выбора и планирования платформенно-зависимых инструкций, но до распределения регистров. (Сейчас развёртывание на этом уровне не поддерживается.)
-
После распределения регистров: барьеры GC развёртываются между распределением регистров и заключительными преобразованиями C2.
-
При генерации кода (позднее развёртывание барьеров): барьеры GC развёртываются при трансляции инструкций IR в машинный код.
Каждая из этих точек предлагает свой компромисс между накладными расходами C2, необходимым знанием C2, риском проблем с планированием инструкций и объёмом платформенно-зависимой работы.
-
Как правило, чем позже развёртываются барьеры, тем ниже накладные расходы C2. Наибольшая экономия достигается, когда развёртывание барьеров переносится с этапа разбора байт-кода на этап после платформенно-независимых оптимизаций, а затем — на этап после распределения регистров.
-
Разработчику, работающему с любой точкой развёртывания, кроме генерации кода, требуются глубокие знания C2.
-
Развёртывание барьеров при разборе байт-кода и после платформенно-независимых оптимизаций не требует поддержки со стороны конкретной платформы, но создаёт риск проблем с планированием инструкций.
-
Развёртывание барьеров при генерации кода, которое предлагается здесь, — вариант с наименьшими накладными расходами и единственный, который не требует от разработчика специфических знаний C2. Как и у всех остальных платформенно-зависимых точек развёртывания, у него есть преимущество (он позволяет избежать проблем с планированием инструкций) и недостаток (для каждой платформы требуются усилия по реализации).
В следующей таблице приведены преимущества и недостатки каждой точки развёртывания:
Точка развёртыванияНакладные расходы C2 Требуются знания C2 Контроль над планированием Платформенно-независимая При разборе байт-кода (раннее) Высокие Да Нет Да После платформенно-независимых оптимизаций Средние Да Нет Да После планирования инструкций Средние Да Да Нет После распределения регистров Низкие Да Да Нет При генерации кода (позднее) Низкие Нет Да Нет
Ещё одно измерение пространства проектных решений — гранулярность реализации барьеров, доступная C2. Для ZGC мы экспериментировали с представлением барьеров одной операцией IR в дополнение к соответствующей операции доступа к памяти, но пришли к выводу, что даже такое более грубое представление создаёт риск проблем с планированием инструкций. Этот вывод, вероятно, применим и к G1, учитывая сходство проблем с планированием у обоих сборщиков.
Тестирование
Чтобы снизить риск функциональных сбоев, мы объединим
-
регулярное тестирование на основе обширного, уже имеющегося набора тестов JDK, который выполняется в различных конфигурациях внутренней системой тестирования Oracle,
-
новые тесты для случаев, которые сегодня покрыты недостаточно, и
-
стресс-тестирование компилятора и GC для проверки редких путей выполнения кода и условий, которые иначе могут быть упущены.
Чтобы снизить риск регрессий производительности, мы оценим новую реализацию с помощью набора отраслевых стандартных бенчмарков Java на разных платформах.
Для измерения и сравнения скорости компиляции и размера кода мы будем использовать функциональность, которую предоставляет опция HotSpot -XX:+CITime. Чтобы контролировать разброс размера и набора компилируемых методов между запусками JVM, мы будем измерять несколько итераций каждого запуска бенчмарка и использовать опции JVM, такие как -Xbatch, чтобы сделать каждый запуск более детерминированным.
Риски и допущения
-
Как и при любом изменении, затрагивающем взаимодействие основных компонентов JVM (в данном случае сборщика мусора G1 и компилятора C2), существует немалый риск внести ошибки, которые могут вызвать сбои и привести к регрессиям производительности. Чтобы снизить этот риск, мы проведём внутренние ревью кода, а также выполним обширное тестирование и измерение производительности сверх обычного объёма работ для рядовых улучшений и исправлений ошибок, как описано выше.
-
В контексте G1 imprecise card marking — это оптимизация, которая позволяет избежать нескольких вызовов JVM при последовательности записей в разные поля одного и того же объекта. Текущая реализация этой оптимизации, основанная на раннем развёртывании барьеров, не дала значимого прироста производительности на уровне приложений. Поэтому мы предполагаем, что для соответствия качеству генерируемого сейчас кода реализовывать imprecise card marking для позднего развёртывания барьеров не нужно. Однако наша работа может в будущем сделать возможной более выгодную реализацию imprecise card marking.